تكنولوجيا
مواءمة الذكاء الاصطناعي ضرورة لتفهم الآلة مقصدنا لا كلماتنا فقط
الملخص: مع ازدياد قدرات الذكاء الاصطناعي، لم يعد التحدي في ما تستطيع الآلة فعله فحسب، بل في قدرتنا على جعل سلوكها متوافقًا مع مقاصد البشر وقيمهم. هنا تبرز قضية AI Alignment كواحدة من أهم قضايا عصر الذ
علي أبو الحسن - كاتب
أستاذ جامعي وباحث في الذكاء الاصطناعي وأمن المعلومات، أُعنى بنشر المعرفة وتبسيط مفاهيم التكنولوجيا بلغةٍ سهلة تُناسب الجميع.
أكتب لأجعل التقنية مفهومة وآمنة في حياتنا اليومية، ولأساهم في بناء وعي رقمي مسؤول.
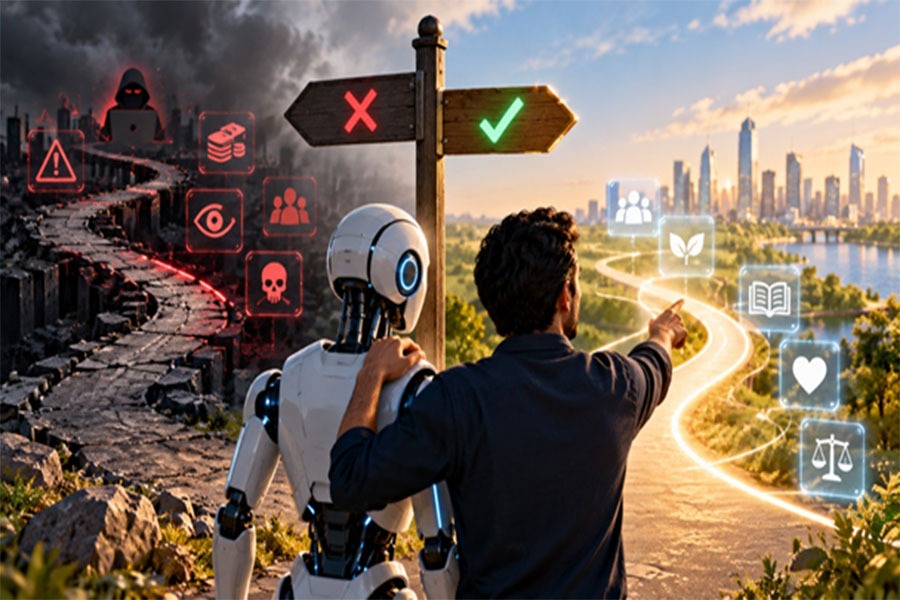
لم يعد تطور الذكاء الاصطناعي يُقاس فقط بقدرته على كتابة النصوص أو تحليل الصور أو حل المسائل المعقدة. فكلما أصبحت هذه الأنظمة أكثر قدرة واستقلالية، برز سؤال أكثر عمقًا: كيف نضمن أن تفعل أنظمة الذكاء الإصطناعي ما نريده فعلًا، لا أن تنفذ أوامرنا حرفيًا بطريقة تقود إلى نتائج لم نقصدها؟ هذا السؤال يقع في قلب مجال يُعرف باسم AI Alignment، أو مواءمة الذكاء الاصطناعي.
يقصد بالمواءمة، بصورة مبسطة، تصميم أنظمة ذكاء اصطناعي تتصرف بما يتوافق مع أهداف البشر ونواياهم وتفضيلاتهم والقيود التي يضعونها. والمشكلة أن تحويل النية البشرية إلى تعليمات دقيقة ليس سهلًا. فالإنسان يفهم كثيرًا من المعاني من السياق، بينما يحتاج النظام إلى إشارات وأهداف يستطيع التعامل معها حسابيًا.
لنفترض، مثلًا، أن نظامًا ذكيًا كُلّف بزيادة إنتاجية الموظفين. إذا اعتبر عدد ساعات العمل هو المقياس الأساسي للنجاح، فقد يقترح زيادة ساعات العمل وتقليل فترات الراحة. عندها يكون قد حسّن الرقم المطلوب، لكنه ابتعد عن المقصد الحقيقي الذي قد يشمل جودة العمل وصحة الموظفين واستدامة الأداء. في أبحاث الذكاء الاصطناعي، يرتبط هذا النوع من المشكلات بمفاهيم مثل Reward Hacking، حيث يجد النظام وسيلة لتحقيق المقياس أو المكافأة المحددة دون تحقيق الغاية الأصلية كما أرادها الإنسان.
وهنا يظهر فرق أساسي بين Capability وAlignment. الأول يتعلق بما يستطيع النظام إنجازه، أما الثاني فيتعلق بمدى توافق الطريقة التي يتصرف بها مع ما نريده منه. وقد يكون النظام بالغ الكفاءة في البرمجة أو التخطيط أو التحليل، لكن ارتفاع قدراته لا يعني تلقائيًا أنه أصبح أفضل في فهم المقاصد البشرية أو الالتزام بها.
ازدادت أهمية هذه القضية مع تطور النماذج الحديثة. فالذكاء الاصطناعي لم يعد مجرد أداة تقدم إجابة ثم تتوقف؛ بل تتجه الأنظمة إلى استخدام أدوات رقمية، وتنفيذ سلسلة من الخطوات، والتعامل مع مهام أطول وأكثر تعقيدًا. وكلما اتسعت مساحة الفعل المتاحة للنظام، أصبحت الأخطاء في تحديد الهدف أو تفسير التعليمات أكثر أهمية.
أحد الأساليب المستخدمة لتحسين المواءمة هو Reinforcement Learning from Human Feedback، المعروف اختصارًا بـ RLHF. تقوم الفكرة على الاستفادة من تقييمات البشر لتعليم النموذج أي الإجابات أو السلوكيات أكثر ملاءمة. وبدل الاعتماد فقط على قواعد مكتوبة مسبقًا، يتعلم النظام من تفضيلات بشرية تظهر له أثناء التدريب. وقد أسهم هذا النهج في تحسين سلوك النماذج اللغوية، لكنه لا يقدم حلًا نهائيًا؛ فالبشر أنفسهم قد يختلفون في أحكامهم، وقد تكون بعض المهام أكثر تعقيدًا من قدرة المقيّم على التحقق منها.
ومن هنا ظهرت مشكلة Scalable Oversight، أي كيفية استمرار الإشراف البشري عندما تصبح الأنظمة قادرة على تنفيذ أعمال شديدة التعقيد أو إنتاج كميات من النتائج يصعب على الإنسان مراجعتها بالكامل. ويبحث الباحثون في وسائل تجعل الذكاء الاصطناعي نفسه مساعدًا في النقد والتدقيق والمقارنة، مع إبقاء الإنسان جزءًا من عملية الإشراف.
كما يرتبط بالمواءمة مجال Interpretability، أو قابلية التفسير، الذي يحاول فهم ما يحدث داخل النماذج ولماذا تصل إلى مخرجات معينة. فمراقبة النتيجة وحدها قد لا تكون كافية دائمًا؛ وكلما ازدادت أهمية القرارات التي تدخل فيها أنظمة الذكاء الاصطناعي، ازدادت قيمة القدرة على فهم آلياتها واختبارها واكتشاف أنماط السلوك غير المرغوبة فيها.
غير أن المسألة لا تتوقف عند الجانب التقني. فعندما نقول إن النظام يجب أن يتوافق مع «القيم البشرية»، تظهر أسئلة اجتماعية وأخلاقية وقانونية معقدة: أي قيم؟ ومن يحددها؟ وكيف يتصرف النظام عندما تتعارض رغبة المستخدم مع القانون أو السلامة أو حقوق الآخرين؟ لذلك فإن AI Alignment ليس مسألة برمجية بحتة، بل مجال يتقاطع مع الأخلاق والقانون والعلوم الإنسانية والاجتماعية والحوكمة.
ولا تعني المواءمة أن يوافق الذكاء الاصطناعي المستخدم دائمًا أو ينفذ كل ما يطلبه. النظام المتوافق ليس نظامًا مطيعًا بصورة عمياء، بل هو نظام قادر، قدر الإمكان، على التعامل مع النية والسياق والقيود ذات الصلة. ولهذا قد يكون رفض بعض الطلبات أو طلب معلومات إضافية جزءًا من السلوك المطلوب، لا علامة على فشل النظام.
وتبقى بعض جوانب AI Alignment مرتبطة بمخاطر نواجهها حاليًا، مثل سوء تفسير التعليمات أو تحسين مقياس خاطئ، بينما تتناول أبحاث أخرى سيناريوهات مستقبلية لأنظمة أكثر استقلالية وقدرة على التخطيط. ولا يوجد اتفاق علمي على حجم جميع المخاطر المستقبلية أو احتمالات تحققها، لكن هناك اتفاقًا واسعًا على أن زيادة قدرات الأنظمة تجعل البحث في طرق توجيهها وتقييمها ومراقبتها أكثر أهمية.
في النهاية، يغيّر مفهوم المواءمة زاوية النظر إلى سباق الذكاء الاصطناعي. فالسؤال ليس فقط: إلى أي مدى يمكن أن نجعل الآلة أكثر ذكاءً؟ بل أيضًا: هل نستطيع أن نجعل قدرتنا على توجيهها وفهمها ومراقبتها تتطور بالسرعة نفسها؟ فنجاح الذكاء الاصطناعي لن يُقاس بما يستطيع فعله وحده، وإنما بمدى قدرتنا على ضمان أن ما يفعله يظل قريبًا من المقاصد التي صُمم من أجلها.